Comment l’IA apprend à partir de données : mécanisme, étapes et limites
Comment l’IA apprend à partir de données : mécanisme, étapes et limites
Quand on demande comment l’IA apprend, la réponse tient en une idée simple : elle observe des exemples, ajuste un modèle interne, puis vérifie si ce modèle sait reconnaître de nouveaux cas. L’apprentissage automatique repose donc sur un trio très concret : données, entraînement et prédiction.
Ce mécanisme paraît abstrait tant qu’on ne sépare pas les rôles. Les données servent à montrer des exemples. Le modèle apprend des régularités. La validation mesure la qualité du résultat. Dans cet article, on suit ce chemin pas à pas, avec des cas simples, des limites réelles et les distinctions qui évitent les confusions les plus fréquentes.
Sommaire
En bref
🧠 L’IA n’apprend pas comme un humain : elle ajuste des paramètres à partir d’exemples, puis généralise sur de nouvelles données.
📊 La qualité des données compte autant que leur volume : des données biaisées produisent souvent des résultats biaisés.
🔍 Validation, test et entraînement ne servent pas au même moment. Les mélanger fausse l’évaluation du modèle.
⚠️ Une IA peut sembler fiable tout en se trompant sur des cas rares, nouveaux ou mal représentés.
Comment l’IA apprend-elle à partir de données ?
L’IA apprend en transformant des exemples en ajustements internes. Pendant l’entraînement, elle compare ses réponses à la réalité attendue, corrige ses erreurs, puis répète l’opération jusqu’à obtenir une performance utile. Le but n’est pas de mémoriser chaque cas, mais de dégager une règle assez stable pour prédire correctement sur des données nouvelles.
- Observer des données : images, texte, nombres, sons ou historiques.
- Repérer des régularités : motifs, corrélations, catégories ou comportements.
- Ajuster le modèle : modifier ses paramètres pour réduire l’erreur.
- Vérifier la généralisation : tester sur des cas jamais vus.
Ce point est essentiel : une IA n’“écrit” pas une règle à la main. Elle la déduit à partir d’exemples. C’est la différence entre un programme classique, conçu instruction par instruction, et un modèle qui apprend une relation statistique entre entrées et sorties.
Que contiennent les données d’entraînement, de validation et de test ?
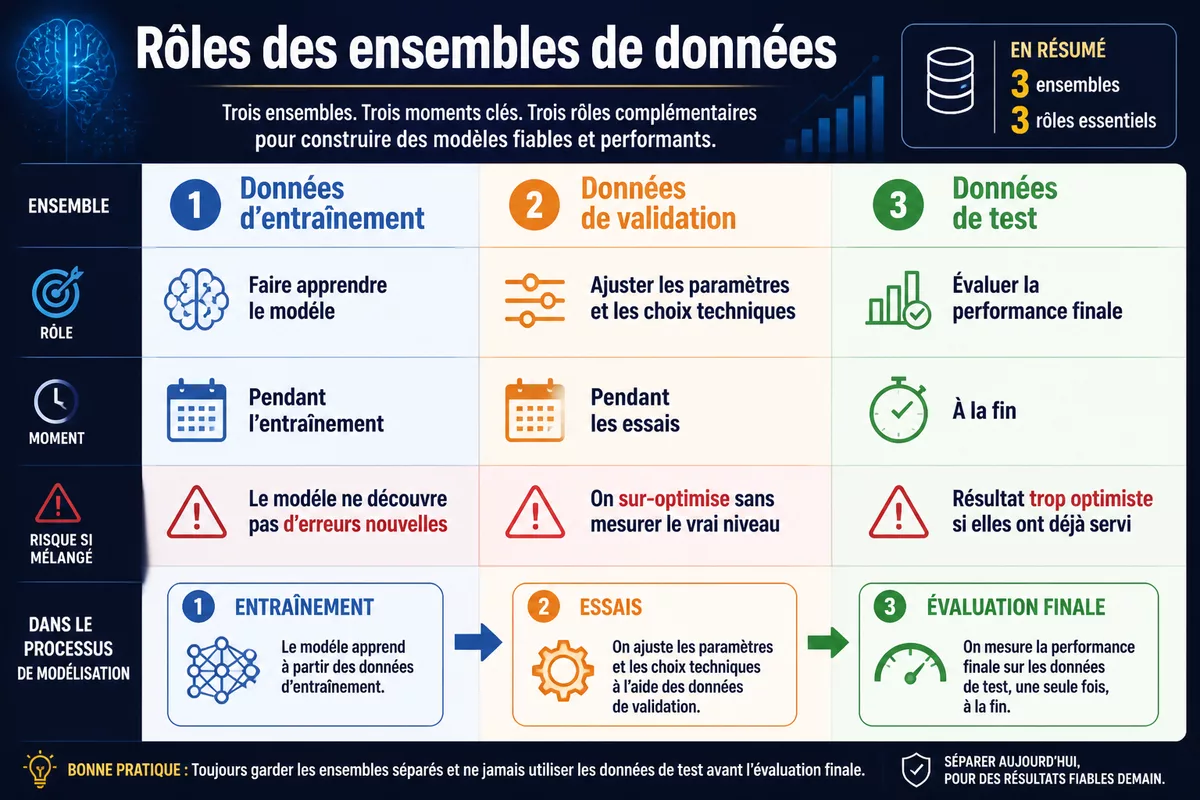
Les données n’ont pas toutes le même rôle. Les données d’entraînement servent à apprendre. Les données de validation servent à ajuster le modèle pendant qu’il se construit. Les données de test servent à vérifier, à la fin, si le modèle fonctionne vraiment hors de l’échantillon. Séparer ces ensembles évite de se tromper sur la qualité réelle du système.
| Ensemble | Rôle | Moment d’usage | Risque si on le mélange |
|---|---|---|---|
| Données d’entraînement | Faire apprendre le modèle | Pendant l’entraînement | Le modèle ne découvre pas d’erreurs nouvelles |
| Données de validation | Ajuster les paramètres et les choix techniques | Pendant les essais | On sur-optimise sans mesurer le vrai niveau |
| Données de test | Évaluer la performance finale | À la fin | Résultat trop optimiste si elles ont déjà servi |
Autrement dit, plus un ensemble sert tôt dans le processus, moins il doit servir à l’évaluation finale. Si le modèle a déjà “vu” les réponses du test, la note obtenue n’a plus de valeur. C’est une erreur classique en apprentissage automatique, surtout quand on veut aller vite.
Quels sont les grands types d’apprentissage automatique ?
On distingue généralement trois grandes familles : l’apprentissage supervisé, l’apprentissage non supervisé et l’apprentissage par renforcement. Chacune répond à une situation différente. Le bon choix dépend de la nature des données, de la question posée et du type de résultat attendu.
| Type | Principe | Exemple simple | Limite fréquente |
|---|---|---|---|
| Supervisé | Apprendre à partir de données étiquetées | Reconnaître un spam ou une photo de chat | Besoin de réponses fiables au départ |
| Non supervisé | Trouver des groupes ou des structures sans réponse fournie | Regrouper des clients par comportement | Interprétation parfois moins évidente |
| Par renforcement | Apprendre par essais, erreurs et récompenses | Un agent qui apprend une stratégie de jeu | Nécessite un cadre de récompense bien conçu |
- Supervisé : utile quand on connaît déjà la bonne réponse à montrer au modèle.
- Non supervisé : utile quand on cherche des structures cachées dans les données.
- Par renforcement : utile quand l’objectif est une suite de décisions, pas une seule réponse.
Un modèle n’invente pas le sens : il apprend une relation entre des entrées et des sorties.
Dans l’apprentissage supervisé, le modèle reçoit des exemples corrigés : image et étiquette, message et catégorie, historique et cible. Dans le non supervisé, aucune réponse n’est fournie au départ ; le système cherche des ressemblances, des groupes ou des variables cachées. Dans le renforcement, le modèle agit, reçoit une récompense ou une pénalité, puis ajuste sa stratégie.
Plus les données sont propres, cohérentes et représentatives, plus la généralisation a des chances d’être solide.
Quelles sont les étapes de l’entraînement d’un modèle ?
L’entraînement suit une logique précise : collecter des données utiles, les préparer, entraîner le modèle, le valider, puis corriger ce qui doit l’être. Ce n’est pas une action unique, mais une suite d’allers-retours. Si une étape est négligée, la qualité finale baisse vite, même avec un grand volume de données.
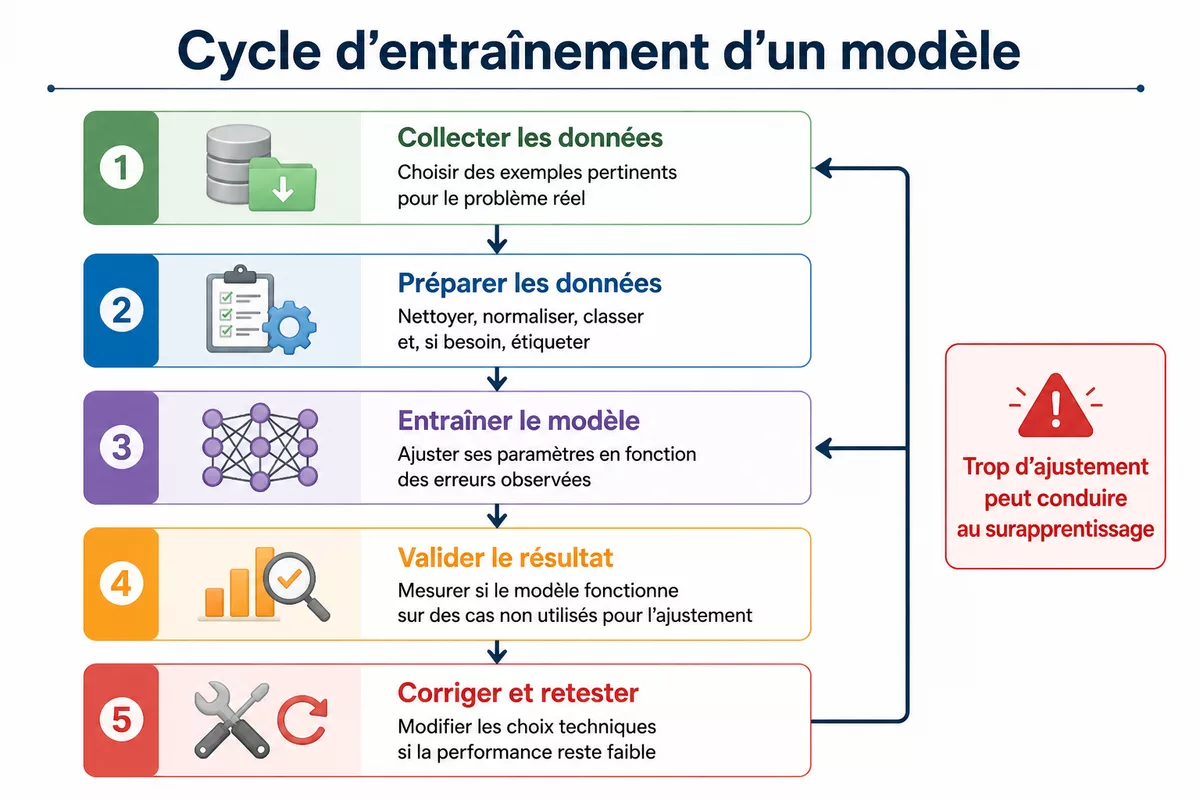
- Collecter les données : choisir des exemples pertinents pour le problème réel.
- Préparer les données : nettoyer, normaliser, classer et, si besoin, étiqueter.
- Entraîner le modèle : ajuster ses paramètres en fonction des erreurs observées.
- Valider le résultat : mesurer si le modèle fonctionne sur des cas non utilisés pour l’ajustement.
- Corriger et retester : modifier les choix techniques si la performance reste faible.
Le mot apprendre désigne ici une optimisation statistique. Le modèle cherche à réduire une erreur. Chaque passage sur les données améliore ses paramètres jusqu’à un certain point. Ensuite, il faut s’arrêter au bon moment. Trop d’ajustement peut conduire au surapprentissage : le modèle devient très bon sur les exemples vus, mais moins bon sur les nouveaux cas.
Exemples concrets : reconnaissance d’images, recommandations et texte
Les exemples les plus parlants sont souvent les plus ordinaires. Une IA qui reconnaît un chat dans une photo, propose une vidéo ou classe un message en spam suit le même principe général : elle repère des régularités dans des données d’apprentissage, puis applique ces régularités à une situation nouvelle. C’est là que l’on voit vraiment comment l’IA apprend.
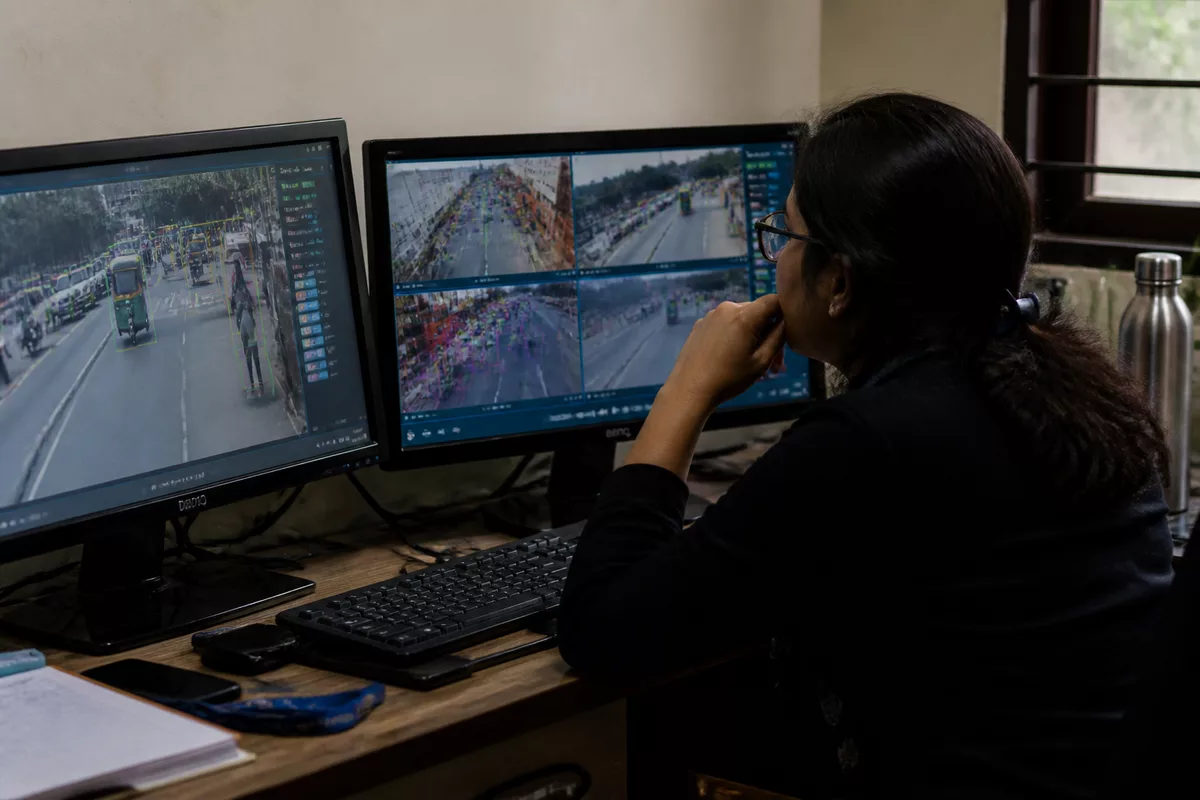
Dans la pratique, on retrouve trois usages très fréquents :
- Reconnaître des images : distinguer un visage, un véhicule, un animal ou un défaut visuel.
- Faire des recommandations : suggérer un film, un article ou un produit selon les comportements passés.
- Comprendre du texte : classer un message, compléter une phrase ou répondre à une demande simple.
Ces systèmes paraissent très différents à l’écran, mais la logique sous-jacente reste proche. Ils s’appuient sur des exemples, apprennent des correspondances, puis produisent une sortie probable. La nuance importante, c’est que cette sortie n’est jamais une certitude absolue. Elle dépend de la qualité des données et du contexte d’usage.
Quelles sont les limites de l’apprentissage par les données ?
La première limite tient à la qualité des données. Si les exemples de départ sont incomplets, mal étiquetés ou déséquilibrés, le modèle peut apprendre un biais. La seconde limite est la généralisation : un modèle peut être performant sur les cas qu’il connaît, puis se tromper dès que la situation change un peu.
Il faut aussi surveiller trois risques concrets :
- Surapprentissage : le modèle retient trop bien les exemples vus et perd en souplesse.
- Biais des données : une sous-représentation d’un groupe ou d’un cas fausse les résultats.
- Confidentialité : certaines données utilisées pour l’apprentissage peuvent être sensibles.
Dans les usages réels, cela compte beaucoup. Une IA entraînée sur des images d’un environnement précis peut se tromper ailleurs. Un filtre antispam peut bloquer un message légitime. Un système de recommandation peut enfermer un utilisateur dans un profil trop étroit. Le problème n’est pas seulement technique ; il est aussi statistique et parfois éthique.
Une IA n’est pas meilleure que les données qui la nourrissent.
Cette phrase résume bien le mécanisme. Une machine apprend vite, mais elle n’invente pas la correction d’un biais absent des données. C’est pourquoi la préparation, la sélection et la vérification des jeux de données comptent autant que l’algorithme lui-même.
Comment vérifier qu’un modèle est vraiment fiable ?
On juge la fiabilité d’un modèle en regardant sa performance hors entraînement, sa stabilité sur plusieurs cas et sa capacité à rester correcte quand les données changent un peu. Une bonne validation ne cherche pas seulement un score élevé. Elle cherche un comportement cohérent, reproductible et adapté au problème réel.
Avant de faire confiance à un modèle, on peut passer par cette vérification simple :
- Regarder les données utilisées : sont-elles représentatives du cas réel ?
- Comparer entraînement et test : l’écart est-il raisonnable ?
- Tester sur des cas nouveaux : le modèle tient-il face à l’inattendu ?
- Contrôler les erreurs fréquentes : y a-t-il un biais systématique ?
Dans un cadre professionnel, on complète souvent ce contrôle par des métriques adaptées : précision, rappel, taux d’erreur ou autre indicateur métier. Le bon indicateur dépend du problème. Pour un filtre antispam, rater un message peut coûter moins cher que bloquer un message important. Pour un diagnostic, la priorité n’est pas la même.
À retenir
- 🧩 L’IA apprend en ajustant un modèle à partir d’exemples, pas en copiant des règles fixes.
- 📁 Séparer entraînement, validation et test évite de surestimer la qualité du modèle.
- 🎯 Le choix entre supervisé, non supervisé et renforcement dépend de la question posée.
- ⚖️ Des données biaisées produisent souvent des résultats biaisés, même avec un bon algorithme.
- 🔒 La fiabilité se vérifie sur des cas nouveaux, pas seulement sur les exemples déjà vus.
FAQ
Une intelligence artificielle comprend-elle vraiment ce qu’elle apprend ?
Pas au sens humain. Elle repère des régularités statistiques et les transforme en prédictions ou en décisions. Le résultat peut être utile sans qu’il y ait compréhension consciente au sens strict.
Faut-il énormément de données pour bien apprendre ?
Pas forcément. La quantité aide, mais la qualité, la représentativité et l’étiquetage comptent souvent davantage. Un petit jeu de données propre vaut mieux qu’un grand ensemble très bruité.
Pourquoi une IA se trompe-t-elle parfois sur un cas nouveau ?
Parce qu’elle généralise à partir d’exemples passés. Si le nouveau cas diffère trop de ce qu’elle a vu, ou si les données d’origine sont biaisées, l’erreur devient plus probable.
Qu’est-ce que le surapprentissage, en pratique ?
C’est le moment où le modèle devient trop spécialisé sur ses exemples d’entraînement. Il réussit très bien les cas connus, mais perd en performance dès qu’il rencontre de nouvelles données.
Peut-on faire confiance à tous les résultats d’une IA ?
Non. Il faut vérifier le contexte, les données utilisées et les limites du modèle. Pour un usage sensible, la validation humaine et la source des données restent indispensables.
Sources utiles à consulter
Pour approfondir le sujet avec des repères fiables, on peut consulter la documentation pédagogique de l’IBM sur le machine learning, les ressources de Microsoft Azure sur l’apprentissage automatique, ainsi que des contenus académiques comme ceux de l’Université et des organismes de recherche en sciences des données. Ces sources aident à vérifier les définitions et les grandes familles de méthodes.